Nem a IA consegue montar um móvel da Ikea sem errar
Pesquisadores usam móveis montados com erros para avaliar a capacidade dos modelos de raciocinar sobre espaço e solucionar problemas
Montar móveis da Ikea não é para os fracos. Tanto que o folclore em torno da marca sugere que montar uma cômoda, uma cama ou qualquer outro móvel da fabricante sueca pode gerar tensão suficiente até para destruir um relacionamento.
Mas, além de serem trabalhosos de montar, esses móveis acabam se mostrando excelentes testes para avaliar o quanto os modelos de IA são realmente inteligentes, graças ao raciocínio espacial e à capacidade de solucionar problemas necessários para montar cômodas Malm ou estantes Billy.
Aiden Ament e Greg Burnham, pesquisadores da Epoch AI, uma organização sem fins lucrativos dedicada à pesquisa em inteligência artificial, divulgaram recentemente um relatório detalhando o Furniture Assembly Benchmark, uma métrica desenvolvida para testar a inteligência real dos modelos de IA. O teste se concentra em avaliar a capacidade do modelo de identificar erros em móveis da Ikea parcialmente montados.
Em um momento no qual as empresas de tecnologia adoram se gabar de quão inteligentes são seus modelos, pode ser complicado avaliar o quão “inteligente” cada modelo realmente é, especialmente em comparação com os demais.
Pedir ao ChatGPT ou ao Claude que identifique erros na montagem de móveis da Ikea coloca os modelos à prova em aplicações do mundo real. E, embora nenhum tenha acertado 100% das vezes, tudo indica que eles estão evoluindo rapidamente.
O TESTE DA IKEA
Os pesquisadores começaram a desenvolver o benchmark durante um retiro da empresa, quando tentavam descobrir como montar um experimento para testar as capacidades da IA.
“Primeiro, tentamos agir como ‘o robô da IA’: perguntávamos o que deveríamos fazer e tentávamos seguir suas instruções de maneira relativamente literal. Os resultados muitas vezes eram confusos”, conta Burnham.
“Gostei mais da ideia final, que foi de Aiden Ament: pedir que ela identificasse os erros. Isso reflete a realidade de que não há problema em cometer erros durante uma montagem, desde que você consiga identificá-los e corrigi-los.”
Os pesquisadores usaram três produtos no experimento, escolhidos de acordo com diferentes níveis de dificuldade do próprio Índice de Complexidade da Ikea: a sapateira Ställ, para o nível fácil; a estrutura de cama Tonstad, para o nível médio; e a cômoda Gullaberg, como o item mais complexo.
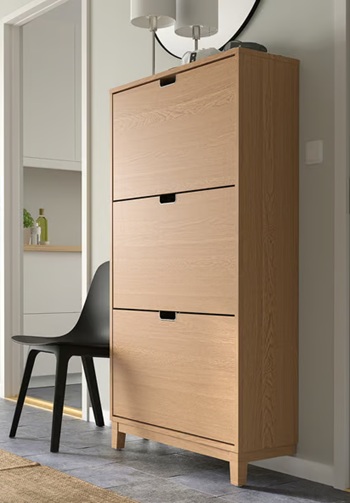
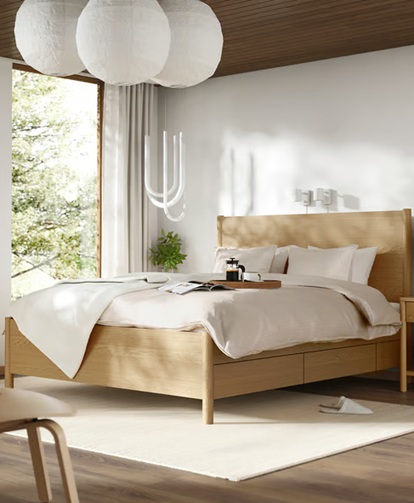
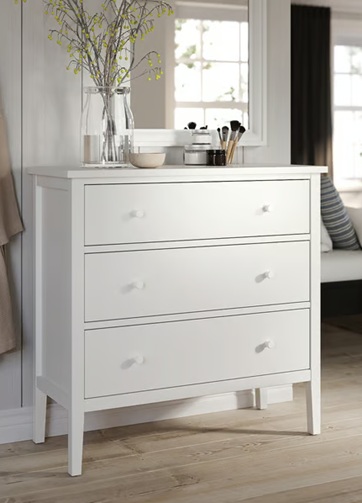
Eles montaram cada móvel, cometendo erros de propósito ao longo do processo, e tiraram 60 fotos de diferentes etapas para fornecê-las aos diversos modelos de IA da OpenAI, Anthropic, Google, Moonshot e Alibaba.
Além das imagens, os pesquisadores forneceram a cada modelo de IA um PDF com as instruções de montagem, uma ferramenta para ampliar cada imagem e um interpretador de Python.
Cada modelo de IA recebeu a tarefa de identificar quais erros haviam sido cometidos pelo usuário e em que momento da montagem eles ocorreram, sendo avaliado de acordo com o benchmark. Além disso, os pesquisadores pediram ao modelo que fornecesse aos usuários uma explicação para cada erro identificado.
IA E RACIOCÍNIO ESPACIAL
O benchmark não trata apenas de montar móveis da Ikea. A intenção é ir além, medindo até que ponto esses modelos poderiam orientar e solucionar problemas em montagens mais complexas.
“Se os modelos conseguirem raciocinar com rapidez e precisão suficientes nesse domínio, é plausível que a IA em breve possa oferecer orientação confiável e em tempo real para tarefas complexas de montagem e reparo físico”, escreveram Ament e Burnham no relatório.
“Acreditamos que esse desafio funciona como um bom indicador de uma série de tarefas economicamente importantes que exigem raciocínio visual e espacial semelhante, como consertar um carro ou reparar eletrodomésticos.”
apesar dos avanços, os modelos continuam apresentando limitações, especialmente em velocidade e precisão.
Inicialmente, o modelo com melhor pontuação no teste era o Claude Opus 4.5, da Anthropic, com apenas 28% de precisão. Mas, em 10 meses, a OpenAI rapidamente alcançou esse resultado, com seu modelo GPT-6 Astra chegando a 80%.
Entre as descobertas mais relevantes estava a velocidade com que os modelos conseguiam fornecer uma resposta: o GPT-6 Astra, vencedor do teste, levava cerca de três minutos por foto, até 10 vezes mais rápido que outros modelos. Os chineses pareciam estar mais atrasados nesse avanço, ficando atrás dos modelos norte-americanos.
Ainda assim, embora o progresso no raciocínio espacial e na solução de problemas em um período tão curto pareça promissor, os modelos continuam apresentando limitações, especialmente em velocidade e consistência da precisão.
Leia mais: Boa noite, smartphone: Ikea cria cama para celular e premia quem vai dormir
“O desenvolvimento de IA é um processo que exige muito capital, e o crescimento da receita das empresas de IA é necessário para que os investimentos continuem. Por isso, estamos sempre procurando áreas para avaliar em que ainda não vemos um impacto significativo da IA”, diz Burnham.
“Se a IA puder capacitar trabalhadores de fábricas a reparar máquinas complexas, por exemplo, isso poderá levar a menos tempo de inatividade.”