Implante cerebral decodifica fala e gestos de pessoas com paralisia
Cientistas desenvolvem interface capaz de decodificar fala e gestos ao mesmo tempo, abrindo caminho para formas mais naturais de interação com máquinas
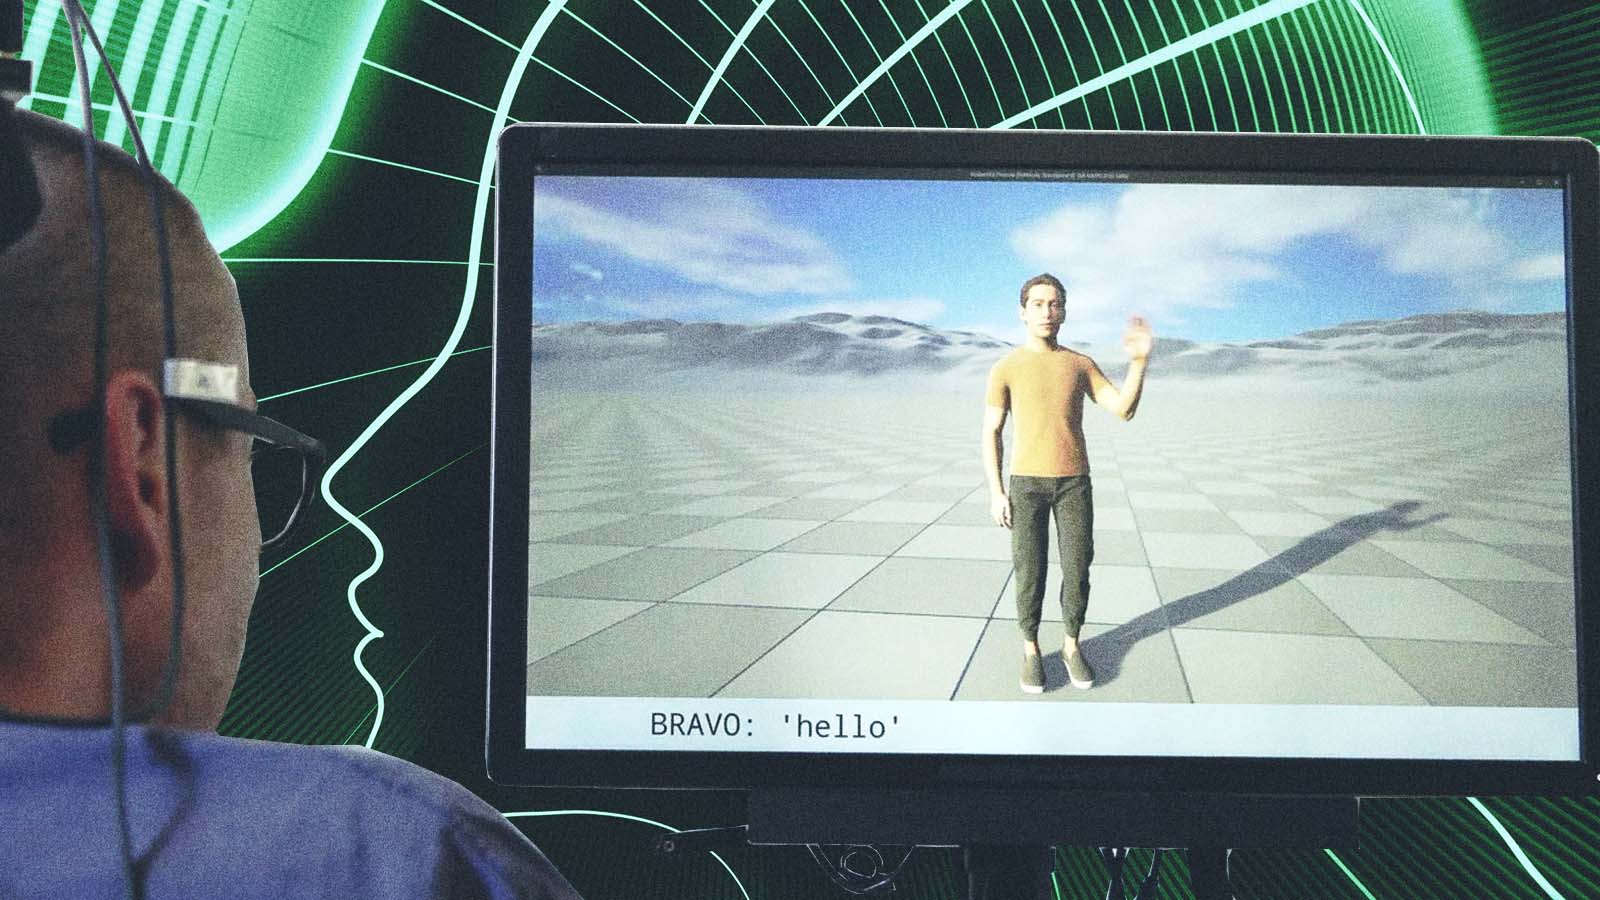
Pela primeira vez, um único implante cerebral consegue interpretar as tentativas de uma pessoa com paralisia de falar e fazer gestos ao mesmo tempo, transformando-as em texto e nos movimentos de um avatar digital.
De acordo com um artigo científico publicado na revista "Nature", o dispositivo utiliza modelos de inteligência artificial para interpretar a atividade cerebral e transformar seus impulsos em fala e linguagem corporal.
As atuais interfaces cérebro-computador (BCIs, na sigla em inglês) conseguem decodificar apenas uma coisa de cada vez. É possível traduzir a fala de maneira confiável ou interpretar gestos com precisão, mas não fazer as duas coisas simultaneamente.
Esses sistemas enfrentam dificuldades porque as áreas do cérebro envolvidas na fala e nos movimentos das mãos durante a comunicação se sobrepõem parcialmente. Agora, cientistas da Universidade da Califórnia demonstraram que seu novo sistema consegue processar fala e gestos em conjunto graças à inteligência artificial.
Por enquanto, a tecnologia consegue lidar apenas com vocabulários limitados e decodificar fala e gestos em dois participantes. A precisão também está longe de ser perfeita.
Ainda assim, representa um grande avanço, porque os seres humanos se comunicam não apenas por meio da linguagem, mas também pelos movimentos do corpo e expressões faciais.
“Nosso objetivo de longo prazo é avançar em direção ao que chamamos de ‘interface cérebro-computador de corpo inteiro’: uma única interface cerebral capaz de restaurar múltiplas formas de comunicação e movimento”, afirma Samantha Brosler, uma das principais autoras do estudo.
“Em princípio, os sinais decodificados de fala e movimento poderiam ser usados para controlar um avatar virtual, outras tecnologias assistivas ou um substituto robótico físico”, explica.
Desde os anos 2000, cientistas vêm desenvolvendo interfaces cérebro-computador capazes de acionar determinados movimentos de braços robóticos. Mas a equipe quer ir além desses gestos predefinidos e desenvolver sistemas que controlem continuamente os movimentos de todo o corpo de maneira natural.
Isso exigirá tornar a decodificação dos sinais cerebrais mais rápida e precisa, além de investigar se o feedback sensorial em tempo real pode fazer com que o controle de avatares ou robôs pareça mais natural e intuitivo.
Na avaliação da pesquisadora, o estudo estabelece uma base inicial para o desenvolvimento futuro de um sistema capaz de oferecer um controle flexível e multifuncional, que poderá tornar tudo isso possível.
DOIS SINAIS, UM ÚNICO CÓRTEX CEREBRAL
Quando a paralisia interrompe a comunicação entre o cérebro e o corpo, o cérebro continua emitindo comandos. É isso que permite aos cientistas desenvolver implantes de interfaces cérebro-computador capazes de captar os sinais elétricos que representam essas instruções.
O implante é uma matriz de eletrocorticografia de alta densidade, projetada para captar esses comandos.
Imagine uma pequena lâmina flexível coberta por uma grade regular de minúsculos pontos metálicos, posicionada diretamente sobre a superfície do cérebro, nas regiões responsáveis pelo controle dos movimentos e da fala.
As tentativas de movimentar as mãos e os braços aparecem em uma região da grade; os movimentos da cabeça e dos olhos, em outra; e os sinais relacionados à fala e aos movimentos da boca, na parte inferior.
O estudo demonstrou a decodificação simultânea durante conversas curtas, e não em interações prolongadas.
O problema é que as áreas cerebrais responsáveis pela fala e pelos gestos se sobrepõem, o que dificulta a interpretação dos sinais pelos computadores. Os pesquisadores descobriram que alguns eletrodos eram ativados só durante a fala, outros apenas durante os gestos e alguns durante as duas atividades.
Foi aí que entrou o treinamento de modelos de inteligência artificial, com o objetivo de resolver essa confusão.
A equipe testou modelos treinados exclusivamente com dados de fala ou de movimento e, depois, modelos treinados simultaneamente com os dois tipos de informação.
Os pesquisadores descobriram que os modelos treinados com ambos os conjuntos de dados apresentaram resultados consistentes nos dois contextos e superaram aqueles treinados com apenas um tipo de informação.
SEM TREINAMENTO ESPECÍFICO
Brosler afirma que uma descoberta especialmente promissora foi a capacidade dos modelos de decodificar combinações de fala e gestos que não haviam encontrado durante o treinamento.
Nos testes, os participantes tentaram produzir simultaneamente 10 frases, como “olá” e “prazer em conhecer você”, e 10 gestos, como acenar com a mão e bater palmas.
Os pesquisadores descobriram que a precisão de um dos participantes ao combinar essas ações foi um pouco superior à obtida ao decodificar apenas os gestos ou apenas a fala.
O fato de o sistema conseguir identificar e decodificar essas combinações de fala e gestos com as mãos sem treinamento específico prévio é uma boa notícia. Coletar exemplos de treinamento para todas as combinações possíveis rapidamente se tornaria impraticável, afirma Brosler.
“Um próximo passo importante será determinar de quantos dados de treinamento precisamos para dar suporte a movimentos cada vez mais complexos realizados simultaneamente à fala, sem ter que treinar todas as combinações de ações”, diz ela.
Depois de aperfeiçoar a leitura e a interpretação dos sinais, os pesquisadores usaram os resultados para movimentar um avatar criado no Unreal Engine, uma ferramenta de criação 3D, enquanto a fala decodificada aparecia como texto na tela.
O sistema funcionou muito bem, embora a tradução dos pensamentos em movimentos do avatar não tenha alcançado 100% de precisão em todos os participantes.
A EXPERIÊNCIA DO USUÁRIO
Ainda há problemas a resolver. O estudo demonstrou a decodificação simultânea durante conversas curtas, e não em interações prolongadas. “Minimizar a fadiga era importante para nós”, afirma Brosler.
Por isso, cada participante escolheu estratégias que conseguia executar de maneira consistente. Um deles imaginava os gestos, enquanto o outro tentava falar silenciosamente.
A equipe perguntou a um dos participantes se realizar as duas tarefas ao mesmo tempo era mais cansativo do que executar cada uma separadamente. Ele respondeu que não.
Leia mais: Ciência revela como o cérebro interpreta a beleza artística
“Isso é animador enquanto trabalhamos para permitir conversas mais longas”, acrescenta Brosler.
Como o sistema decodifica frases e gestos específicos, existe um intervalo entre a tentativa de realizar uma ação e a resposta do avatar. A equipe pretende investigar com os participantes qual é a latência aceitável para esse tipo de interação.
DO METAVERSO AO NOSSO UNIVERSO
Além de ajudar pessoas com paralisia, direcionar essa tecnologia de decodificação para um avatar de realidade mista ou para um robô capaz de projetar a presença de alguém a distância é o próximo passo natural.
Em princípio, explica Brosler, os mesmos comandos decodificados de fala e movimento poderiam controlar um avatar em um ambiente de realidade mista ou até mesmo um sistema robótico físico.
“O próprio decodificador não precisa mudar dependendo da maneira como suas saídas são utilizadas”, afirma ela.
A ficção científica há muito tempo imagina cérebros instalados em corpos inteiramente artificiais – e é aí que as possibilidades ficam realmente interessantes.
Brosler considera esse trabalho um primeiro passo nessa direção, embora ressalte que “ainda estamos muito longe de controlar um corpo artificial de maneira fluida”, que é o objetivo final da equipe.
Chegar lá exigirá desenvolver o controle contínuo dos movimentos de todo o corpo, melhorar a velocidade e a precisão da decodificação e explorar como o feedback sensorial em tempo real pode tornar esse controle mais natural e intuitivo.
Mas, pelo menos, sabemos que estamos no caminho certo para resolver uma série de problemas para muitas pessoas – e abrir as portas para um futuro repleto de possibilidades extraordinárias para todos os demais.